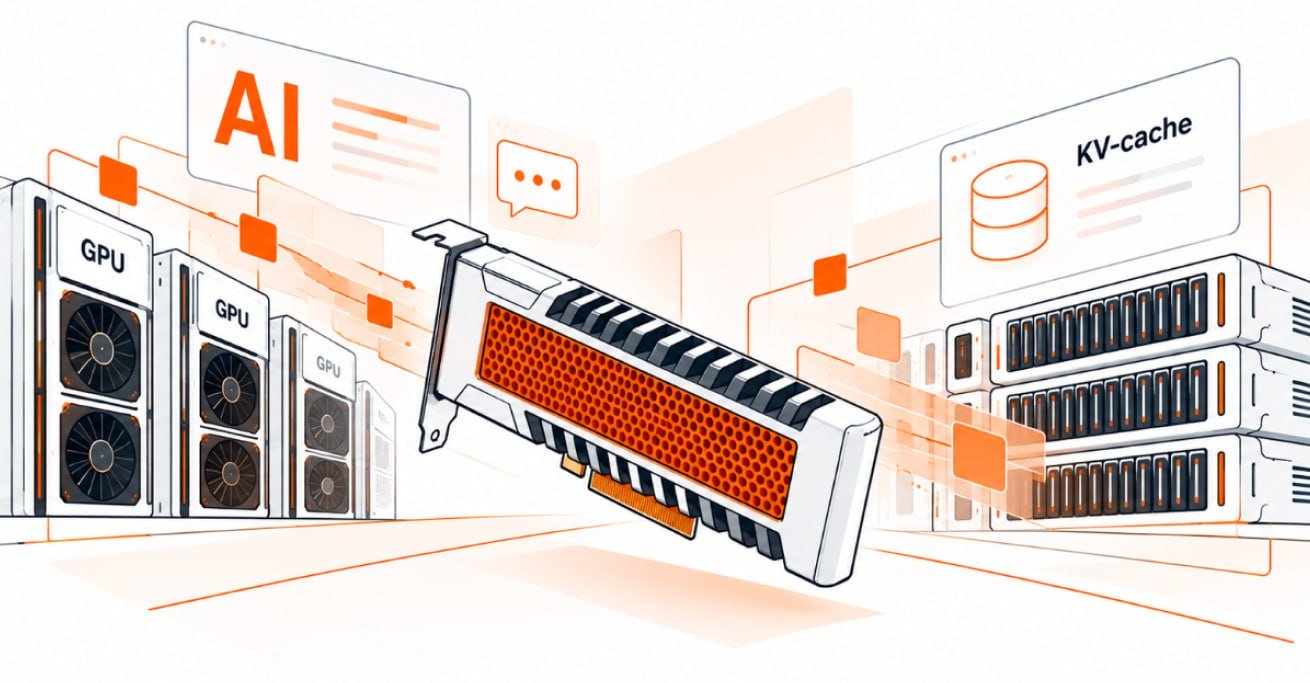
«Тантор Лабс» и «Платформа Боцман» представили программно-аппаратную технологию хранения KV-cache нейросетей во внешнем NVMe-хранилище без использования DRAM. По данным разработчиков, в испытаниях решение позволило обслуживать в четыре раза больше клиентов на тех же GPU-мощностях при соблюдении заданных требований к задержке, сообщили проекту Игнатий Цукергохер в пресс-службе Группы Астра.
Как работает технология
KV-cache хранит промежуточные вычисления, которые LLM используют при генерации ответов. Его объем растет с увеличением длины контекста и числа пользователей. Когда видеопамяти GPU не хватает, приходится ограничивать количество одновременных запросов, выделять дополнительные ресурсы или повторять вычисления.
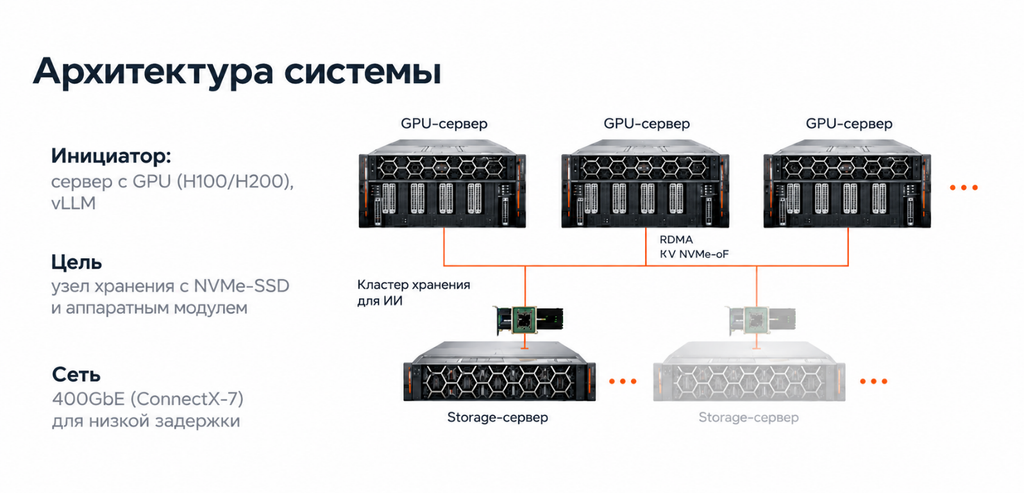
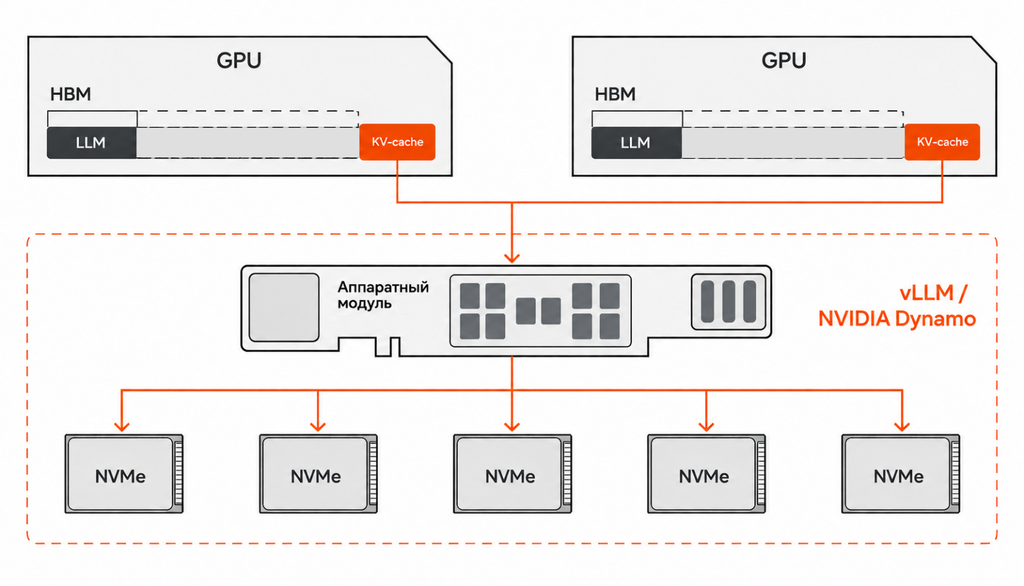
Новое решение переносит KV-cache из HBM-памяти GPU в отдельное NVMe-хранилище по протоколу RDMA. Специализированный аппаратный KV-движок обеспечивает доступ к данным по ключу, снижает нагрузку на центральные процессоры и позволяет повторно использовать сохраненные вычисления.
GPU-серверы с движком инференса vLLM обращаются к узлу хранения на базе NVMe SSD. Для доступа используются сетевые адаптеры 400 GbE ConnectX-7, RDMA и NVMe-oF. Кэш сохраняется в распределенном масштабируемом хранилище Storage AI и может использоваться разными GPU, экземплярами vLLM и пользователями.
Такая архитектура разделяет вычисления и хранение контекста:
- GPU выполняют инференс,
- контекстная память находится в общем хранилище и не привязана к отдельному серверу.
Совместимость
Решение интегрируется с vLLM, LMCache и NVIDIA Dynamo без переписывания прикладного кода. Заявлена поддержка ускорителей:
- NVIDIA — Ampere, Ada Lovelace, Hopper и Blackwell;
- AMD — Instinct и Radeon;
- Alibaba — PPU;
- MetaX — C-Series;
- Baidu — Kunlun.
Результаты испытаний
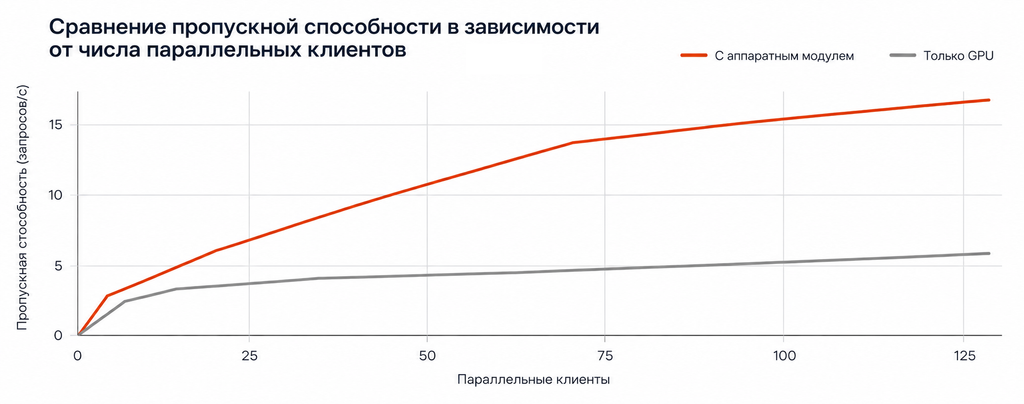
Разработчики сравнили конфигурации с аппаратным модулем и без него на одинаковых серверах, языковых моделях и нагрузке. С модулем число обслуживаемых клиентов выросло в четыре раза без увеличения GPU-мощностей и нарушения заданных требований к задержке, заверили в компании.
По заявлению компаний, скорость доступа к сохраненному контексту сопоставима с DRAM, а емкость и стоимость хранения — с NVMe-накопителями. Повторное использование кэша позволяет сократить перерасчеты, увеличить число запросов на том же парке GPU и снизить стоимость обработки запроса и токена.
«Мы переносим опыт, накопленный в работе с аппаратными технологиями МБД Tantor XData Gen3, для решения задач, которые становятся критически важными в эпоху ИИ. Только программная оптимизация кэширования для ИИ решает часть проблемы, но создает сложности для эксплуатации и имеет заведомо меньшую производительность. Новое решение позволяет ускорить доступ к хранилищу контекстной памяти (KV-cache), освобождая ресурсы серверов для вычислений. В сочетании с платформой „Боцман“ это формирует оптимальную основу для масштабирования ИИ-инфраструктуры, в которой производительность определяется не только мощностью GPU, но и тем, насколько эффективно организована работа с памятью нейросетей»
Вадим Яценко, генеральный директор «Тантор Лабс»
«„Боцман“ обеспечивает промышленную эксплуатацию ИИ-моделей и управление всей инфраструктурой их работы. Интеграция хранилища контекстной памяти (context memory storage) дополняет эти возможности поддержкой программно-аппаратной оптимизации использования KV-cache, позволяя максимально удобно использовать новую технологию в рамках единой платформы управления ИИ-сервисами»
Михаил Кобик, технический директор «Платформы Боцман»